

摘要:国产十万卡AI超算集群采用浸没式相变液冷破解散热瓶颈,台积电同期在台扩产先进封装,算力竞争转向系统级工程。
算力的较量,正从单颗芯片延伸到整座集群与整条产线。中科曙光“曙光8000(登峰)”作为国内首个全国产十万卡AI超算集群,其核心散热方案采用浸没式相变液冷,直面超大算力集群的散热难题。
散热压力源于芯片功耗的陡增。AI芯片单颗功耗已从数百瓦升至1000瓦乃至1200瓦以上。传统风冷在单机柜约25千瓦时逼近物理极限,再往上加,高温会触发芯片降频,集群稳定性随之下滑。业内测算显示,十万颗计算芯片全速运转一年半所产生的热量,足以烧开整个西湖——这一对照说明,散热已不再是配套设施,而是决定算力规模的上限。
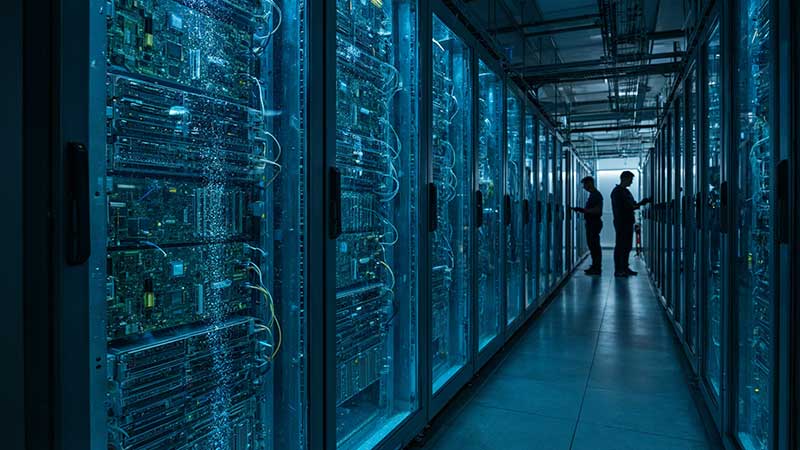
浸没式相变液冷将服务器主板整体浸入特殊冷却液,芯片发热使液体汽化,蒸气在冷凝端释放热量后回流,循环带走热量。相比风冷,该方案换热效率更高、温度分布更均匀,可支撑单机柜数十千瓦乃至更高功率密度,使十万卡集群能够稳定满负荷运行。
与散热并行的另一道瓶颈是封装产能。台积电计划在中国台湾嘉义科学园区新增五座先进芯片封装工厂,建成后当地先进封装工厂总数将达10座。其中P1、P2预计2027年量产,P3至P5同步推进。扩建程序先公示一个月征询意见,再进入可行性研究与环境评估。先进封装(将多颗芯片在封装阶段高密度集成,以弥补单芯片性能增长的放缓)是AI芯片交付的关键环节,CoWoS等产能长期紧张,扩产直接影响GPU供给能力。
两条线索指向同一判断:算力竞争已是系统级工程。芯片制程决定单点性能上限,而液冷决定集群能否把性能跑满,封装决定芯片能否按期交付。三者环环相扣,任何一环掉队都会拖累整体算力供给。
对国内而言,“曙光8000(登峰)”的全国产路径提供了自主算力底座样本。从芯片、整机到液冷系统全链路国产,意味着在外部供应链不确定时,仍保有大规模算力建设能力。十万卡集群的落地,验证了国产液冷与系统集成的工程成熟度。
台积电的封装扩产则提示,全球算力竞赛正在基础设施层面加速。封装产能向特定园区集中,既是规模效应使然,也带来供应链地理集中的新考量。未来算力的区域分布,将更多受封装与散热能力约束,而非仅受晶圆厂位置影响。
算力基础设施的攻坚,本质是把“更高、更快、更省”拆解到散热、封装、供电每一个子系统。当单芯片红利趋缓,系统工程的精细度,将决定一个国家能建多大规模、多稳的算力底座。
