摘要:阿里平头哥在云栖大会推出 AI 芯片真武 V900,算力为真武 M890 的三倍,显存 216GB、片间互联 1200GB/s,单集群可扩至 50 万卡,预计 2027 年 Q1 就绪,已服务 650 多家客户。
阿里把今年云栖大会最重的一颗棋子放在了芯片上。平头哥发布 AI 芯片真武 V900,官方给出的数字相当激进:算力是真武 M890 的三倍,显存 216GB,片间互联带宽 1200GB/s,单集群可扩展至 50 万卡,预计 2027 年第一季度就绪。真武系列维持"一年一代"的节奏,2028 年第三季度将推出 J900;配套的磐久超节点服务器支持千卡全带宽 Scale-Up 互联与百 TB 级统一显存。CPU 侧,倚天 720 与 730 计划在 2027 年第三季度推出。平头哥同时披露,真武已服务 650 多家客户,T-Head SAIL SDK 的核心组件已经开源。
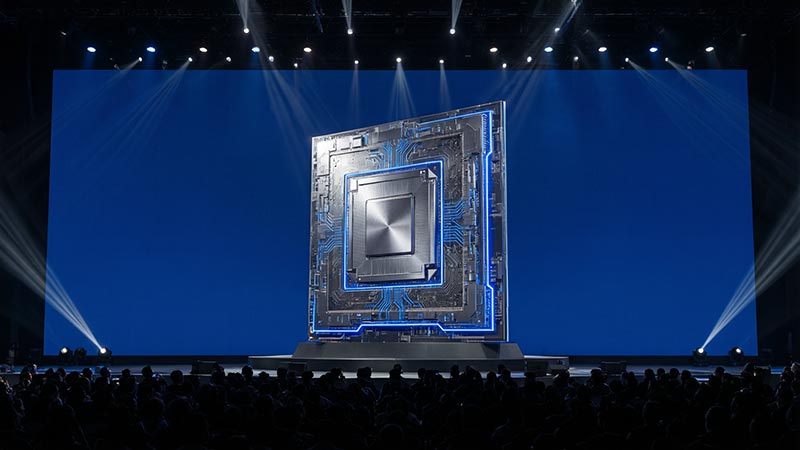
芯片之外还有一张更大的蓝图。阿里同步抛出了下一代 Qwen 模型的计划——参数规模指向 5 到 10 万亿,并给出到 2032 年建成超过 20 吉瓦全球数据中心容量的目标。Reuters 的报道提到,消息公布后阿里股价明显上涨,并把这轮发布放在"出口管制之下中国推进本土 AI 硬件"的语境里解读——尤其考虑到其时间点落在中美高层会谈之前。
真武 V900 的发布时点,本身也是信息。它叠在出口管制持续收紧的背景上,而 Reuters 特意强调市场反应是"股价明显上涨",等于把这个信号解读为对"国产算力能接住下一代模型"的定价。更值得注意的是发布会的组合方式:芯片、超节点服务器、CPU、SDK 开源一起端出,而不是只讲一颗芯片。这种"成套交付"的思路说明,国内厂商现在的目标已经不是"证明自己能造卡",而是"证明客户能整机整集群地买走并跑起来"。
对正在做国产化替代的团队,这条新闻的实用信息是:评估周期可以提前。芯片要 2027 年 Q1 才就绪,但 SDK、集群互联方案与超节点形态现在就能研究——提前把训练框架与互联拓扑的适配问题想清楚,比等芯片到货再动手要省几个月。
把"可扩至 50 万卡"放回国产芯片的坐标系,它的对手其实不是某款国产 GPU,而是英伟达的集群方案——比的是"能不能组大网"。50 万卡意味着要解决的早已不是单卡算力密度,而是供电、散热、故障率与互联丢包,这些恰恰是国产方案过去最薄弱的工程环节。平头哥敢把这个数字写进发布稿,等于在押注自己已经跨过了大规模工程化的那道坎。对采购方,这意味着评估重心要从"单卡算力"转向"集群交付与运维能力"。
我的判断:这条新闻的分量不在跑分,而在"可扩至 50 万卡"这句话。大模型训练的瓶颈早就从单卡算力转移到集群互联与稳定性上,能承诺 50 万卡 Scale-Up 的互联方案,等于在赌"下一代模型就是靠规模堆出来的"。两个数字最该被记住:一是 2027 年 Q1 才就绪,意味着它服务的是明年的训练战役,不是今年的推理生意;二是 5 到 10 万亿参数的 Qwen 计划——如果真落地,它对电力和数据的要求会把"20 吉瓦"从口号变成必须兑现的预算。对普通开发者,SAIL SDK 开源比芯片本身更实用,值得先上手。