摘要:小米发布并开源 MiMo-V2.6 Pro 与 Flash 两款原生全模态模型,Pro 版 AA 综合智能指数达 46 分、为当前最强开源模型;不到 6 天在线强化学习累计约 75 万条轨迹,成本 85 万与 262 万美元。
小米今天发布并开源了 MiMo-V2.6,一次性给了 Pro 与 Flash 两个版本,都是原生全模态模型。最硬的一个数字是:Pro 版在 AA 综合智能指数上拿到 46 分,成为当前最强的开源模型,而 API 沿用 V2.5 的定价——没有借"更强"涨价。训练侧的信息同样有料:在不到 6 天的在线强化学习(Live RL)中,Flash 与 Pro 的成本分别约 85 万和 262 万美元,累计约 75 万条轨迹,DeepSWE v1.1 分别提升约 17 分和 14 分。
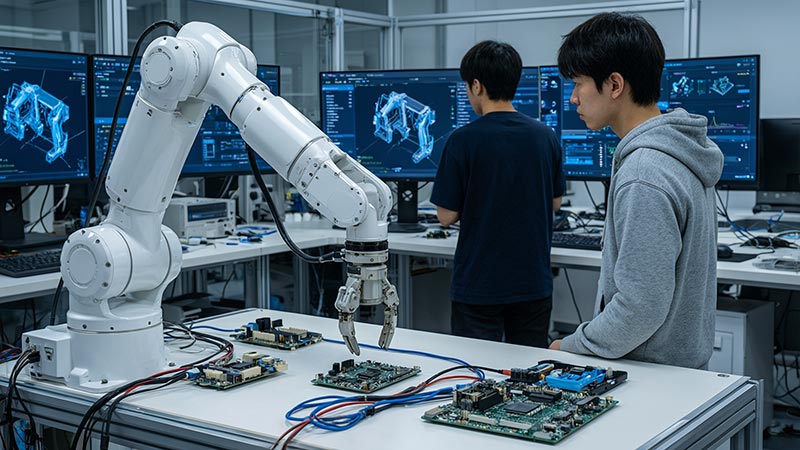
能力展示上,小米给的不是跑分清单,而是一串能"动手"的任务:搭建 3D 游戏、做 Blender 建模、控制机械臂,以及完成 Lean 形式化证明。这些都属于"多步、可验证、需要长期一致性"的任务类型。与此配套,小米同步开源了 7k 以上的强化学习任务环境与端到端训练框架——这一点比模型权重更值得关注,因为它把"如何造出这种模型"的方法论也交了出来。
还有一个容易被忽略的细节是"原生全模态"这个定位。它意味着模型在训练阶段就统一处理文本与视觉输入,而不是在推理时把多个专用模块拼接起来——这类架构在需要跨模态推理的任务上(比如看着屏幕操作界面、根据照片判断机械状态)通常更稳定,也更省推理开销。
另一个值得琢磨的对比是开源的时机:它恰好踩在闭源模型集体降价的那一天。当 API 单价被打到地板,开源模型的"零授权成本"优势会被压缩;但反过来,另一重价值被凸显出来——可私有化部署、可微调、可审计。对金融、医疗、政企这类合规敏感行业,这三条往往比省下的 token 费更值钱。小米选在这天开源,等于同时押注"性能接近第一梯队"和"可掌控"这两张牌。
把 MiMo-V2.6 放进全球开源模型的 timeline 看,它的姿态更清楚——过去一年开源标杆是 Meta 的 Llama 与阿里 Qwen,但两者都偏"发布权重";小米这次把"权重 + 训练环境 + 轨迹数据"一起交出来,等于把开源的定义从"给你模型"推进到"给你造模型的方法"。对高校与中小团队,这意味着第一次能在百万美元预算内复现一个专业级模型的训练过程,而不是只能做微调。开源生态的竞争,正在从"谁更强"转向"谁更可复现"。
我的判断:这条新闻真正的看点是那 75 万条轨迹和 7k+ RL 环境。强化学习正在从"少数实验室的独门工艺"变成"可复现、可外包、可规模化"的工程——训练成本被压到百万美元量级,同时环境与框架全部开源,意味着半年后做出一个"专业级"的开源模型,门槛会低得多。对企业来说,最务实的动作是:把 MiMo-V2.6 拉进自己的评测集跑一遍,特别是机械臂控制与形式化证明这两个方向——如果你的场景恰好落在里面,"免费且能私有化部署"的诱惑是价格战给不了的。