摘要:Meta 第三代自研芯片 MTIA 450 明年上半年进数据中心,第四代 MTIA 500 约一月内完成设计;美光展示全球首个 512GB DDR5 模组;联发科发首款 2nm 天玑 9600 Pro。
AI 算力的军备竞赛,正从"谁 GPU 多"蔓延到整条硬件供应链。三条线同一天传来进展。第一,Meta 计划明年上半年在数据中心部署第三代自研芯片 MTIA 450(代号 Arke),运行 AI 模型时节省成本和能源;第四代 MTIA 500(代号 Astrid)约一个月内完成设计,预计 2027 年底进数据中心。Meta 未来 12 个月对自研芯片的部署承诺已超 1 吉瓦用电当量——这数字本身说明,巨头已经不信任单纯买 GPU 能解决成本和供给问题,自研成了对冲供给风险的必选项。
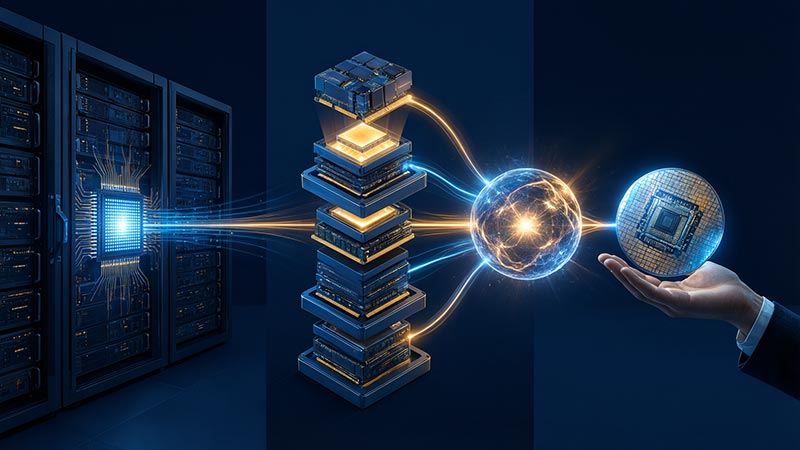
第二,美光展示了全球首个 512GB DDR5 内存模组(3DS RDIMM),通过硅通孔堆叠 DRAM Die 最大化单封装容量。单条 512GB 在双路 24 插槽配置下可实现单服务器 12TB 内存,支持 9200MT/s 传输速率,相比 4 个 128GB 模组节能超 60%。预计 2027 下半年量产,AMD、英特尔正在验证。这对长上下文、KV Cache、并发 Agent 这类"吃内存"的负载是直接利好——很多大模型推理的瓶颈其实不在算力,而在内存带宽和容量。
第三,联发科发布首款 2nm 旗舰手机芯片天玑 9600 Pro,采用台积电 2nm 工艺,"2+3+3"全大核架构,双 NPU 支持端侧运行最高 300 亿参数的混合专家模型;vivo X500 Pro 与 OPPO Find X10 Pro Max 将首发。这把端侧 AI 的硬件水位又往上抬了一截。把三线合看,结论很清楚:当模型从"回答问题"变成"持续运行、调用工具、记住上下文",瓶颈早已不只是 GPU 算力,而是内存带宽、芯片能效和端云协同。美光解决"装得下",Meta 解决"跑得起",联发科解决"带得走"。下一阶段的 AI 硬件竞争,是系统级算账,而不是单颗芯片的跑分。
对投资人来说,这意味着机会从"芯片单一赛道"外溢到"互联、储能、电力、先进封装"的整条链,而这恰恰是被过去两年"唯 GPU 论"低估的洼地。Meta 自研芯片的 1 吉瓦部署承诺,本质上是在用资本开支投票"不把命运全押在英伟达";美光的 512GB 模组则暗示,长上下文和 Agent 并发会让内存成为新的战略物资;联发科的 2nm 则把端侧 AI 的军备竞赛推到硅工艺最前沿。三条线合起来,描绘的是一张"算力民主化但供应链更碎"的地图——赢家不再只有一个,而是分布在每一段瓶颈上。