摘要:长任务 Agent 常因上下文溢出与目标丢失翻车。文章拆解预算控制、压缩、todo-state 与记忆四件套,对抗长程执行的两大顽疾。
长任务 Agent 最经典的两个死法:一是上下文溢出,装不下了;二是跑到一半忘了最初要干嘛。这篇解析把对抗这两大顽疾的工程套路拆成四件套——预算控制、压缩、todo-state 和记忆,讲清它们怎么配合,而不是各自为战。
预算控制是第一道防线。思路很简单:给每次执行划一个 token 上限,超了就触发回收,而不是等模型自己撑爆。它解决的是「无节制生长」,让长任务在有限窗口里必须做取舍。但光有预算不够,因为砍掉什么、保留什么才是学问,这就引出了压缩。
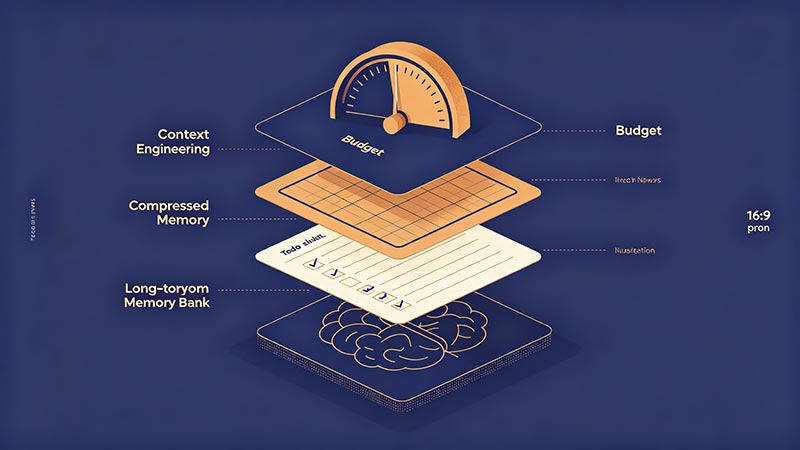
压缩是把「已经发生的事」提炼成「还用得上的事」。原始对话全留太贵,全丢又丢目标,折中做法是分层:近期细节保留,远期摘要化,关键决策做成结构化笔记。好的压缩不是删字,而是把信息降维成模型后续仍能调用的形式。很多 Agent 翻车,正是因为压缩时把「为什么这么做」压没了,只留下「做了什么」,导致后续逻辑断裂。
todo-state 是给 Agent 装的一张任务清单。它把「我要去哪」从模型的隐式记忆里拽出来,变成显式、可检查、可回退的状态。每完成一步就划掉、卡住就标记,协调者一看就知道进度。这招对多步、易偏的任务尤其灵,因为它把「目标」外置了,模型不再全靠注意力硬撑。很多框架的 todo 模块看着简单,却是长任务不跑偏的定海神针。
记忆则是跨会话的延续。短期靠上下文,长期得靠外部存储——把用户偏好、历史结论、领域知识写进可检索的记忆层,下次直接调,而不是每次从零聊。预算、压缩、todo、记忆四者联动:预算逼你做减法,压缩做减法时不丢骨架,todo 保住方向,记忆补上跨轮上下文。少一个,长任务就多一处裂缝。
落地建议:别一上来追求全自动,先把 todo-state 和分层压缩跑顺,再逐步放开自主度。长任务的本质不是「模型更聪明」,而是「状态管理更稳」——工程做好了,中等模型也能跑出让人放心的长流程。
落到工具选择,todo-state 和分层压缩在 LangGraph、AutoGen 等框架里已有雏形,但多数团队用得粗糙:要么 todo 形同摆设,要么压缩把关键决策压没了。建议先把手写版跑顺——一张显式任务清单加一份「近期原文 / 远期摘要」的分层缓存,往往比直接上复杂框架更稳。预算控制记得留余量,别卡到临界才回收。长任务的真相是:模型够不够聪明是次要的,状态管理稳不稳才是命门。工程做扎实了,中等模型也能跑出让人放心的长流程,不必苦等下一代旗舰。
再说一个落地细节:长任务最该补的是可观测性。给 Agent 加 trace,把每一步的入参、出参、调用耗时和失败原因都记下来,出了问题才能定位是预算砍错了、压缩丢了一句话,还是 todo 状态写歪了。很多团队只盯着「它跑完没」,却看不见中间怎么跑的,一旦翻车只能重来。把 Agent 当成可调试的系统而非黑盒,长任务的稳定性才会随迭代真的变好,而不是靠运气。
别忘了人这个闸。长任务里设几个必须人工确认的检查点,成本不高却能在跑偏时及时踩停。全自动是目标,不是起手式。