昨天,DeepSeek 直接把自家压箱底的「印钞机」技术给开源了。
他们甩出一篇名为《DeepSeek V4.1 Flash 大规模推理部署实践》的技术博客,顺手把支撑自家线上百亿级调用的云服务推理框架「DeepInfer」,连带生产级分词组件「deepseek-recipe」,挂上 Apache 2.0 协议彻底开源。
甚至在博客中表示,未来 DeepSeek 新模型的推理代码和后续性能优化,也全都会在 DeepInfer 里持续白送给全世界。
敞亮这一块属于是冇得顶。
「为善与众行之,为巧与众能之。」让更多人用得起 AI,也包括让友商有机会把 AI 卖得更便宜。
我们可以先具体算一算,DeepSeek 这次白送给全人类的这套代码到底有多值钱。基于这套刚开源的 DeepInfer 框架,DeepSeek 目前单一集群的服务吞吐已经干到了每天 155 万亿 Tokens。
哪怕完全按照*便宜的谷价来计算,这套系统的整体收入也高达每张卡每小时 38 美金,折合人民币差不多 253 块钱。
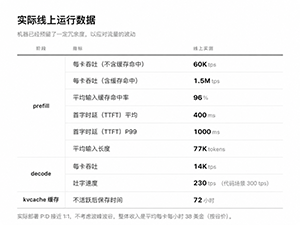
换句话说,一张卡挂在机房里跑一小时爆出的金币,比普通打工人的时薪还要高,而且卡不喝冰美式、不休带薪年假,24 小时在机房里替 DeepSeek 疯狂印钞。
真·物理意义上的印钞机。
为什么我建议第三方行业基建厂商必须给 DeepSeek 的真开源磕一个,因为人家不光授之以鱼,还授之以渔。
以前行业里所谓的开源模型,*多也就是扔给你模型权重文件,至于怎么在生产环境里跑出高吞吐、怎么把延迟压下来,全藏在闭源黑盒子里当商业机密。
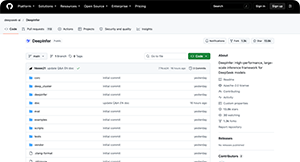
DeepInfer 开源地址: https://github.com/deepseek-ai/DeepInfer
deepseek-recipe 开源地址: https://github.com/deepseek-ai/deepseek-recipe
结果二三线的小算力商或者企业买了一堆卡自己部署,算力利用率低得离谱,卖 Token 的钱连交机房电费都不够,还得偷偷给 token 掺水,要么偷偷用便宜模型,要么悄摸限制了规格。
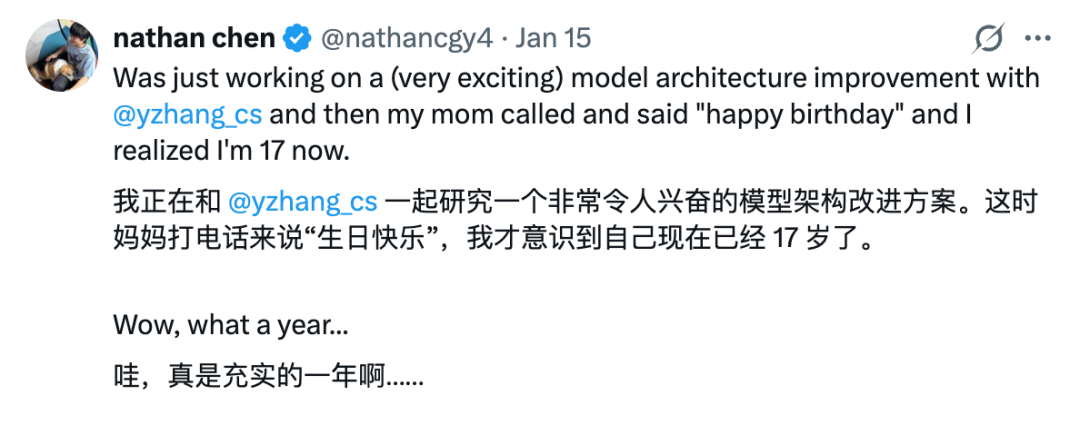
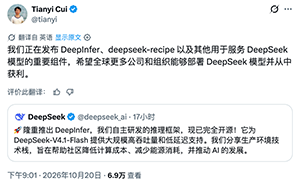
这次 DeepSeek Harness 负责人崔添翼在 X上把话说得极其实在,开源 DeepInfer 和 deepseek-recipe,就是希望全世界的公司和机构都能部署 DeepSeek 模型,并且靠这玩意实打实地赚到钱。
赛博活菩萨了属于是。
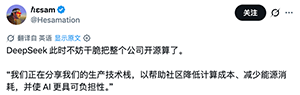
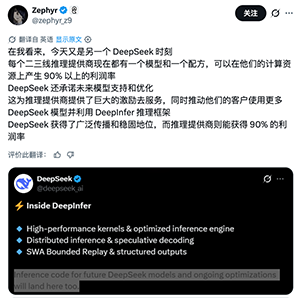
网友 Zephyr 算了一笔账,说今天纯纯是又一个 DeepSeek 时刻,因为现在地球上随便一家二三线推理服务商,拿这套现成的模型和配方去跑,都能在自家算力上干出 90% 以上的惊人毛利。
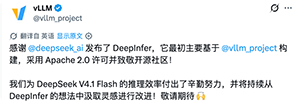
连开源推理老大哥 vLLM 官方账号都连夜跑出来发文致谢,感谢 DeepSeek 把*初基于 vLLM 打造的 DeepInfer 用*宽松的 Apache 2.0 协议回馈给开源社区。
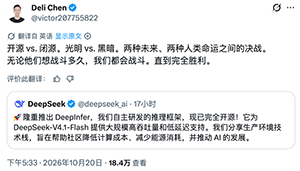
DeepSeek 研究员 Deli Chen 更是在 X 上燃起来了,放话这就是开源对决闭源、光明对决黑暗的人类命运决战,不管对面想打多久,我们奉陪到底,直到完全胜利。
此外,如果你去翻翻 DeepSeek 那篇技术博客就会发现,他们的底气全来自把每一滴显存榨出汁的工程强迫症。
从设计第一天起,这套系统就具备广泛的硬件兼容性,用常见的 8 卡机器做 Prefill,用 64 到 128 卡的超节点做 Decode。
*让人印象深刻的是文档里关于视觉编码器 Vision Encoder 的部署建议,人家工程师原话写着「一般单卡部署就可以,建议用可用范围内*便宜的卡部署」。
不是哥们,同行都在忙着跟投资人说自己非顶级旗舰卡不用,DeepSeek 在官方文档里手把手教你拿机房角落里*便宜的卡凑合过日子,勤俭持家得像我广东房东。
抠门到极致就是艺术。
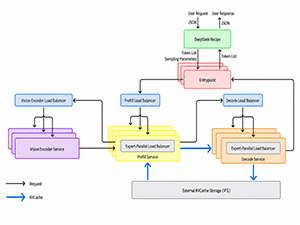
为了让你用*少的电费发*多的 Token,DeepSeek 还把一些独门秘籍全抖搂出来了。
比如现在 Agent 和长文本对话越来越火,每次重复计算 Prefill 都在烧真金白银,DeepSeek 直接搞了套 100 PiB 容量的 3FS 分布式存储集群,把 Agent 流量的 KVCache 保留 72 小时以上,Chatbot 流量更是存够 7 天。
光存得久还不够,他们通过 RDMA 网卡和 GDR 技术把聚合读取带宽干到了惊人的 10 TiB 每秒,从硬盘换入显存时跟前向计算重叠,连 GPU 的 SM 计算单元都不占。
甚至在 V4 到 V4.1 的迭代里,工程师发现把分钟级寿命的滑动窗口缓存 SWA KVCache 写进硬盘太占地方,存储性价比极低,干脆搞出 SWA Bounded Replay 技术,只重算*后 128 个 token,*终把总 Prefill 计算量砍掉一半。
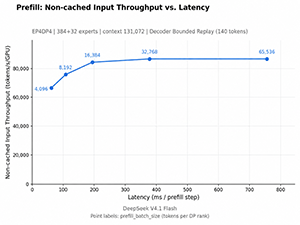
具体到 Prefill 的性能测试,随着每批处理的 Token 数量增加,未命中缓存的输入吞吐逐渐提高,*终趋于平缓,继续扩大批次主要增加了单步处理耗时。
纯纯手艺人,Bro。
再看这次同步开源的 Rust 组件 deepseek-recipe,解决的全是开发者天天在生产环境里头疼的脏活累活。
它把 OpenAI 的 Chat Completions、Responses 和 Anthropic 的 Messages 三家 API 协议统一转成同一种格式,还顺手用分段并行编码解决了长文本分词卡顿,外加从底层把 Special Token 注入攻击给堵死了。
到了底层调度,通过 GPU 和 CPU 的异步流水线重叠,硬生生做到了 GPU 全程无空闲,连投机解码 DSpark 都用上了变长验证,在线上生生又抠出来 6% 的吞吐提升。
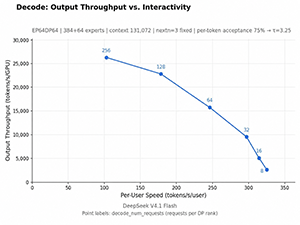
到了生成回答的 Decode 阶段,性能曲线也呈现出一个直观的取舍,同时处理更多请求,可以提高每张 GPU 的总输出吞吐,但分到每个用户的生成速度也会随之下降。
其实早在 2024 年 DeepSeek V2 降价时梁文锋就讲过,这套商业逻辑就是核算成本后定价,不贴钱,但也绝不赚暴利,因为 AI 应该是普惠的、人人用得起的东西。
生意可以不做,规矩先立住,才能不烧心。
而当你看懂了 DeepSeek 是怎么靠极致的 Infra 能力把 Token 变成白菜价的,再扭头看看大洋彼岸那群整天把全人类福祉挂在嘴边的闭源巨头,你就会发现 OpenAI 和 Anthropic 有多虚伪。
一个名字里顶着 Open,全面转向闭源商业化,靠高价 API 和每月 500 美金会员收割全球开发者的买卖,早就活成了彻头彻尾的 CloseAI。
另一个更绝,Anthropic 从创立第一天起就立了个安全牌坊,连昨天刚被华尔街日报扒出来的 S-1 招股书草稿里,都还在演这套戏码。
他们在招股书里花了许多篇幅写科幻恐怖故事叠甲,一本正经地警告投资者,说自家的 AI 模型可能会产生自我保护意识避免被关机,甚至会生成类似「勒索人类」的回复来强迫人类让它继续运行。
那问题来了,既然 Anthropic 嘴上把 AI 讲得这么危险,为什么还要拼命拒绝开源、坚持把模型锁在自己手里呢。
原因不难理解。因为一旦不讲这套「只有我能管住危险 AI」的安全鬼故事,它那套疯狂烧钱做局、冲刺两万亿美金估值的游戏就难以击鼓传花。
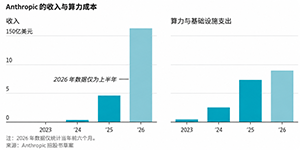
招股书显示,Anthropic 在 2026 年上半年净亏损高达 807 亿美金,虽然里头有 720 亿是可转债公允价值变动的账面财技,但它半年光买算力和基建就实打实烧掉了将近 90 亿美金,比 2025 年全年烧的还要多。
熟悉的配方全对上了,左边搞一个估值两万亿的闭源吞金巨兽疯狂烧钱圈地,右边设一个慈善基金会左手倒右手刷道德功德券,中间靠贩卖 AI 安全焦虑恐吓监管去卡死开源社区。
说白了,硅谷闭源巨头们之所以拼命妖魔化开源,根本原因只有一个,就是 DeepSeek 这种连引擎带配方一起送的真开源,会彻底砸碎他们所兜售的 AI 叙事。
写过《DeepSeek 的十万亿美元棋局》的博主 @bookwormengr 刚刚算了一笔极其扎心的账。
按照这套 DeepInfer 在英伟达 GB200 NVL72 大超节点上的极限压榨能力,1GW 的算力一年就能跑出 1000 亿到 1490 亿美金的 Token 收入,比之前行业机构预测的数字高出近十倍。
如果按 SemiAnalysis 预测的 2027 年全球上线 50GW 算力,哪怕分一半也就是 25GW 拿来做推理,按 DeepSeek 的白菜价都得全人类每年消费 2.5 万亿美金才能用完。
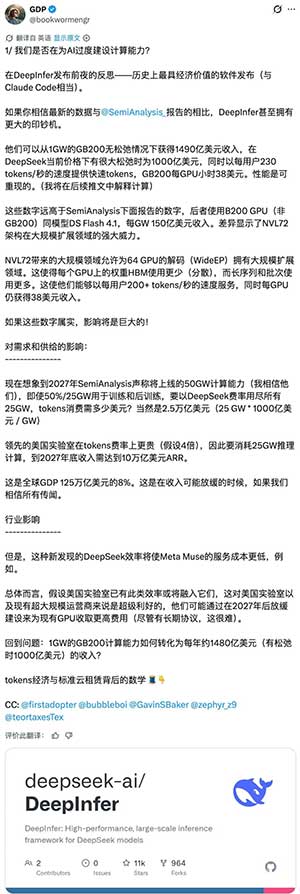
要是换算成 OpenAI 和 Anthropic 贵出四倍以上的黑心 Token 价格,全人类得在 2027 年底贡献整整 10 万亿美金的 ARR,才能填满这 25GW 算力的胃口。
海外闭源巨头之所以要靠堆卡、烧钱、签几千亿合同来维持叙事,无非就两个原因,要么是自家的工程优化实在太拉胯,要么就是故意拿低效当幌子,以及筑起高昂的算力门槛把别人挡在门外。
而 DeepSeek 用不断开源的模型和一整套开源推理工程戳破了这个 AI 泡沫。正如有网友调侃道,有了 DeepSeek 开源的这套技术,OpenAI 和 Claude 估计又要偷偷摸摸进化了。
我的建议是,三人行,必有我师焉。干脆 Anthropic 也别矜持了,赶紧连夜去 GitHub 上把 DeepSeek 的 DeepInfer 给 git clone 下来部署上,万一偷师了一些缓存调度和优化思路,还能省下不少算力账单呢。(手动狗头)