摘要:梳理大模型预训练、微调、对齐三阶段训练流程与MoE架构原理,说明产业竞争正从拼规模转向拼效率。
大模型并非“一次训练成型”。从海量文本到能对话、能解题的助手,中间要经过三个界限分明的阶段:无监督预训练、监督微调、基于人类反馈的对齐。理解这条链路,才能看懂当下“效率竞赛”为何成为产业主旋律。
第一阶段是无监督预训练。模型在万亿级文本上反复练习“预测下一个token(词元,文本被切分后的最小单位)”,由此习得语法、常识与世界知识。这一阶段计算量最大,往往需要数千张GPU连续运转数月。它决定模型“知道多少”,但不保证“会说人话”。
第二阶段是监督微调,即SFT(Supervised Fine-Tuning,监督微调)。工程师准备大量“指令—回答”配对样本,让模型学会按人类期望的格式回应。经过这一阶段,模型从“续写机器”变成能理解指令的助手。SFT数据质量直接决定模型行为边界。
第三阶段是对齐,主流方法包括RLHF(基于人类反馈的强化学习,Reinforcement Learning from Human Feedback)与DPO(直接偏好优化,Direct Preference Optimization)。RLHF收集人类对多个回答的优劣排序,训练奖励模型,再用强化学习让模型偏向高分回答;DPO省去奖励模型,直接对比偏好数据优化。两者目标一致:让输出符合人类价值观,减少有害与偏离意图的回答。
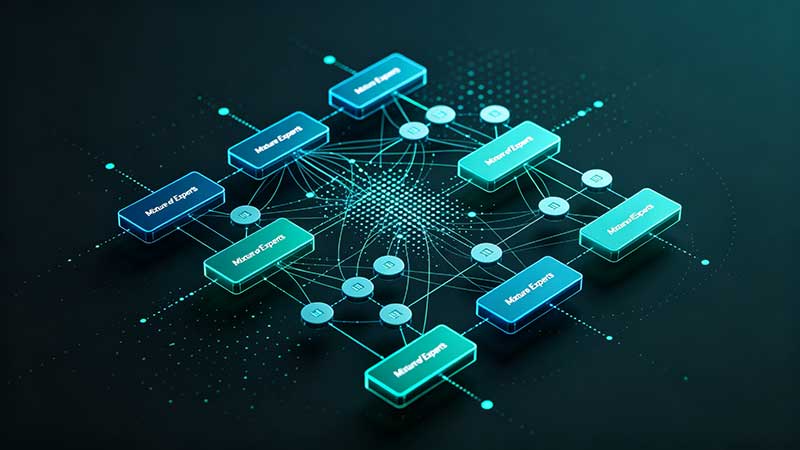
三阶段消耗巨大,如何让模型“既大又省”成为核心课题。MoE混合专家模型(Mixture of Experts,混合专家)给出一条路径。传统模型每次推理都激活全部参数,MoE则内置多个“专家模块”和一个门控网络:门控网络为每个输入挑选少数专家参与计算,其余静默。结果是参数量可以堆到很大,实际计算量却只取决于被激活的部分,推理成本因此大幅降低。
MoE并非无代价。最大挑战是负载均衡:若门控网络总把任务分给少数专家,其余专家长期闲置,不仅浪费参数,还会拖垮训练稳定性。业界通常通过辅助损失函数强制均匀分配,或在路由策略上做改进。
长上下文是另一项基础能力。一年前,百万token(词元)上下文窗口还是旗舰模型专属,如今已成标配。难点在注意力计算:标准注意力对长文本的开销接近输入长度的平方。KDA混合线性注意力通过改变计算结构,将该开销从近平方级压到近线性级,使长文档处理在成本上可行。
训练与架构的革新,共同指向一个趋势:行业正从“规模竞赛”转向“效率竞赛”。动态路由、神经符号混合等新型架构不断出现;专用AI芯片与Flash Attention(一种优化注意力计算、减少显存读写的算法)等软硬协同手段,把推理成本压到消费级与边缘设备也能承受的区间。
把视角拉通,本篇所讲训练与架构,正是上篇推理优化的上游。训练阶段决定模型“能做什么”,MoE与长上下文决定“做起来贵不贵”,推理优化决定“最终跑起来省不省”。全链路每一环的改进,都在把大模型的门槛往下拉。